Highlight
Gemeinsam erfolgreich – unser valantic Team.
Lernen Sie die Menschen kennen, die mit Leidenschaft und Verantwortung bei valantic Großes bewegen.
Mehr über uns erfahren11. November 2026
Die Preise für Inferenz sind in den vergangenen Jahren um rund 90 Prozent gesunken. Doch wer sich umhört, erfährt: Bei fast niemandem ist die Rechnung gesunken. Wirksames KI-Kostenmanagement beginnt mit der Frage nach dem Warum: Was treibt die Rechnung, welches Modell leistet die Arbeit, und was bringt das Geld?
Der Preis pro Token hat die Rechnung nie bestimmt. Das Volumen tat es, dazu die Wahl des Modells, die Menge des hineingestopften Kontexts und die Zahl der Wiederholungen, bis jemand mit dem Ergebnis zufrieden war. Günstigere Einheiten führen vor allem dazu, dass mehr davon genutzt werden, weil sich Dinge, die im letzten Quartal nicht automatisierungswürdig waren, plötzlich lohnen.
Hier stößt das alte Denkmodell des Abonnements an seine Grenzen. Eine klassische Softwarelizenz kostet dasselbe, ob Sie die Anwendung zweimal im Monat oder vierhundertmal öffnen; der zusätzliche Klick ist gratis. Bei KI ist keine zusätzliche Handlung gratis. Jeder Prompt und jedes eingefügte Dokument verbraucht Tokens, ebenso jede Wiederholung, jeder Tool-Aufruf und jede Validierungsschleife, die Sie nie zu sehen bekommen. Alles wird gemessen und landet auf der Rechnung. Die nutzungsbasierte Abrechnung legt lediglich eine Kostenstruktur offen, die Pauschalabonnements bisher verdeckt haben.
Agentische Workflows verschärfen das Problem auf eine Weise, die die meisten Budgets nicht berücksichtigen. Eine einzige Anweisung, „aktualisiere dieses Feature, teste es, liefere es aus“, wirkt für die Person, die sie tippt, wie eine einzelne Aufgabe. Darunter liest das System womöglich ein Repository, plant, durchsucht Dokumentation, erzeugt Code, führt Tests aus, scheitert, repariert, startet neu, lässt ein zweites Modell prüfen und repariert erneut. Das sind ein Dutzend Maschinenschritte hinter einem Satz, und die gesamte Kette kann etwa das Tausendfache der Tokens eines einfachen Chats verbrauchen. Führen Sie dieselbe Aufgabe zweimal aus, können die Kosten je nach Weg des Agenten um den Faktor 30 abweichen. Die Durchschnittswerte sehen unauffällig aus, während die Ausreißer die Rechnung treiben.
Weder ein kleineres Modell noch ein strengerer Budgetalarm löst das allein. Entscheidend ist zu wissen, welcher Hebel (Volumen, Modellwahl, Kontextgröße, Wiederholungen) Ihre Rechnung in welche Richtung zieht.
Ein Modell, das hervorragend über Ihre Dokumente nachdenkt, erkennt nicht automatisch, wann es etwas tun soll, das eine einfache Regel oder Abfrage für einen Bruchteil der Kosten erledigen könnte. Die meisten KI-Budgets versickern in dieser Lücke zwischen dem, was ein Modell kann, und dem Urteil darüber, wann man es einsetzt.
Die meisten KI-Modellpaletten sehen gleich aus: oben ein Flaggschiff, in der Mitte eine solide Option und unten etwas Kleines, Schnelles, wobei zwischen den beiden Enden preislich etwa der Faktor 10 liegt. Fast jedes Team greift standardmäßig zum Flaggschiff und bleibt dabei.
Die Gewohnheit ist nachvollziehbar. Das Flaggschiff steht in der Ankündigung, und es ist die sichere Wahl, denn niemand wird dafür kritisiert, das stärkste verfügbare Modell gewählt zu haben. So landet Arbeit mit hohem Volumen und geringer Mehrdeutigkeit wie Klassifikation, Tagging, Extraktion und Routing im teuersten Reasoning-System am Markt. Das ist die Beschaffungsvariante davon, mit Kanonen auf Spatzen zu schießen. Es funktioniert, ist für die Aufgabe aber absurd überdimensioniert.
Die bessere Frage lautet: Was ist das kleinste, günstigste Modell, das diese Anforderung zuverlässig erfüllt? Die Antwort ändert sich mit jedem Workload, deshalb muss sie eine Architekturentscheidung sein und keine einmalige Auswahl. Leiten Sie die meisten Anfragen an kleine, schnelle Modelle, führen Sie eine Konfidenzprüfung durch und eskalieren Sie nur die unsicheren Fälle an das teure Modell, bei dem sich die zusätzliche Leistung lohnt.
In unseren Projekten hat Routing die Kosten halbiert, ohne messbaren Qualitätsverlust. Ähnlich wirkt Kontextdisziplin. Wenn ein Orchestrator jedem Agenten nur den Kontext mitgibt, den sein Schritt braucht, statt in einem langen Chat den gesamten Verlauf immer wieder zu verarbeiten, sinkt der Token-Verbrauch um mehr als die Hälfte, und die Zuverlässigkeit steigt. Die Batch-Verarbeitung bringt einen pauschalen Rabatt von 50 Prozent, den die meisten Unternehmen nie abrufen.
Dieselbe Logik gilt schon, bevor Sie überhaupt zu einem Sprachmodell greifen. Ein stabiles, gut gelabeltes Klassifikationsproblem ist meist ein Fall für klassisches maschinelles Lernen (ML), das dasselbe Ergebnis zu einem Bruchteil der Kosten pro Aufruf liefert. Eine eingescannte Rechnung ist ein Fall für Document AI, ein Defekt an einer Produktionslinie ein Fall für Computer Vision. Nichts davon braucht ein Frontier-Modell, das von Grund auf darüber nachdenkt.
Vor jedem neuen Anwendungsfall lohnt eine kurze Abfolge von Fragen:
Die meisten Projekte springen direkt zu „Welcher Chatbot?“ und stellen die früheren Fragen nie.
Fragen Sie einen Raum voller Führungskräfte nach den KI-Kosten, und die meisten nennen Ihnen eine Zahl auf den Euro genau. Fragen Sie, was diese Ausgaben gebracht haben, wird es still im Raum.
Von Menschen, die komplexe Organisationen führen, würde man diese Lücke nicht erwarten, doch sie zeigt sich überall. In einer Umfrage unter rund sechstausend Führungskräften in vier Ländern gaben neun von zehn an, in den vergangenen drei Jahren keinen messbaren Effekt von KI auf Beschäftigung oder Produktivität festgestellt zu haben, rechnen aber für die nächsten drei Jahre mit deutlichen Zuwächsen. Sie erwarten also weiterhin, dass sich KI auszahlt; den Effekt in den eigenen Zahlen finden sie nur noch nicht.
Die Gesamtausgaben sind die einzige Zahl, die fast jedes Unternehmen erfasst. Vier weitere entscheiden darüber, ob sich das Geld gelohnt hat, und die meisten Unternehmen erfassen keine davon:
Uber hat Berichten zufolge sein jährliches KI-Budget für die Softwareentwicklung innerhalb weniger Monate aufgebraucht und konnte auf der Suche nach dem Ertrag nicht klar belegen, was die Ausgaben der Entwickler für einen Coding-Assistenten bei den Kunden bewirkt haben. Dasselbe Muster sehen wir in unseren eigenen Teams und bei unseren Kunden. Wenn eine technisch so versierte Organisation wie Uber diese Lücke nicht schließen kann, ist die Annahme, es im eigenen Haus ohne gezielt aufgebaute Messung zu schaffen, Optimismus.
Das erfordert kein Forschungsprogramm. Ein Gateway, eine Trace-ID, die die gesamte Aufrufkette übersteht, und eine Konvention, mit der jede Anfrage dem zugehörigen Prozess zugeordnet wird, ergeben etwa zwei Wochen Entwicklungsarbeit. Es fehlt, weil es vor dem Rollout niemand festgelegt hat, und nachträglich lässt es sich kaum einbauen, denn die Absicht hinter Anfragen, die schon gelaufen sind, lässt sich nicht mehr rekonstruieren.
Der wichtigste Unterschied ist der zwischen Warnung und Kontrolle. Wenn eine Budgetbenachrichtigung bei 70 Prozent der Ausgaben eintrifft, hat sie nichts verhindert. Eine echte Leitplanke sitzt im Anfragepfad und greift ein: Sie stuft das Modell herab, kürzt den Kontext, begrenzt die Wiederholungen oder stoppt den Prozess. Bei allem, was agentisch und autonom läuft, trennt diese Leitplanke ein System mit Ausgabenlimit von einem offenen Haftungsrisiko mit freundlicher Oberfläche.
KI-Kostenmanagement läuft auf zwei Entscheidungen hinaus: welches Werkzeug zur Aufgabe passt und ob sich messen lässt, was es liefert.
Ein Frontier-Modell für ein deterministisches Problem einzusetzen, ist architektonische Faulheit mit monatlicher Rechnung. Die interessante Designarbeit, und dort verdient sich ein guter Umsetzungspartner sein Geld, besteht darin zu erkennen, wann ein viel kleineres Modell oder gar kein Modell die Aufgabe genauso gut für deutlich weniger erledigt.
Planen Sie das KI-Kostenmanagement, bevor der erste Prompt rausgeht, denn nachträgliches Aufsetzen funktioniert nicht.
Wollen Sie wissen, wohin Ihr KI-Budget fließt? Sprechen Sie mit unseren Expertinnen und Experten über KI-Kostenmanagement.

Künstliche Intelligenz 16. Oktober 2026
Autonomous Enterprise Journey: Wie AI Value Engineering messbaren Geschäftswert schafft
Wie lässt sich der ROI von KI-Initiativen zuverlässig bewerten und messen? Woran erkennen Unternehmen die größten Hebel und entscheidenden Prozesse für AI? Antworten und Empfehlungen gibt Katrin Luft, Senior Expert bei valantic & Mitentwicklerin der „Autonomous Enterprise Journey“, im Gespräch mit Darya Basarhina, Vice President Sales & Marketing und Manufacturing Practice Lead bei valantic.
Autonomous Enterprise Journey: Wie AI Value Engineering messbaren Geschäftswert schafft
Customer Experience 8. Oktober 2026
Interview: Vom PIM zur Data Spine – Wie Unternehmen ihre Daten für KI vorbereiten
KI verändert die Anforderungen an Daten, Governance und Prozesse. Wo fangen Unternehmen am besten an und welche Fähigkeiten braucht es? Im Interview sprechen Dietmar Rietsch, CEO von Pimcore, und Timo Huguet von valantic über die Bedeutung sauberer Datens, die Idee der „Data Spine“ und die veränderte Rolle des Menschen im Zeitalter von Agentic AI.
Interview: Vom PIM zur Data Spine – Wie Unternehmen ihre Daten für KI vorbereiten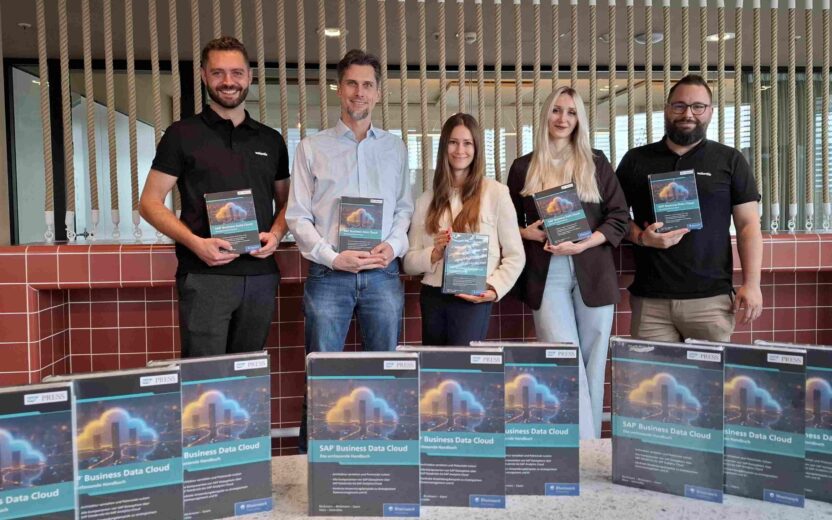
SAP Services 17. September 2026
Interview zum SAP BDC Handbuch über Business AI und Datenkultur
Fünf valantic Beraterinnen und Berater haben das Handbuch SAP Business Data Cloud geschrieben. Im Interview erläutern sie, warum SAP BDC der Enabler für Business AI ist und warum man das Buch unbedingt gelesen haben sollte.
Interview zum SAP BDC Handbuch über Business AI und DatenkulturNichts verpassen.
Blogartikel abonnieren.